AI Agent 全解析
更新: 10/14/2026字数: 0 字 时长: 0 分钟
AI Agent 全解析:从"会说话"到"会干活"
很多人都有过这样的体验:ChatGPT 能流利地回答任何问题,但一旦让它"帮我订一张下周三去上海的机票,顺便查一下那边三天的天气",它就只会输出一段"建议你这么办"的文字,而不是真正把票订了、把天气查了。
问题的根源很简单:大语言模型(LLM)只会"说",不会"做"。它的本质是预测下一个 token——它能生成文字,却不能调用外部工具、不能记住上次说过的话、也不能自己拆解并执行一个多步骤任务。
而 AI Agent(智能体),正是为了解决这个问题而生。它给 LLM 装上了一套能"思考、规划、动手、记忆、循环推进"的完整框架,让 AI 从被动应答的"聊天工具",进化成主动完成任务的"数字员工"。
本文按一条清晰的线索展开:先搞懂 Agent 是什么、由什么组成,再看它如何通过一个循环不断运转,最后深入到它的每个"器官",并延伸到多智能体协作。
一、Agent 是什么:给 LLM 装上"手脚"
先给一个一句话定义:
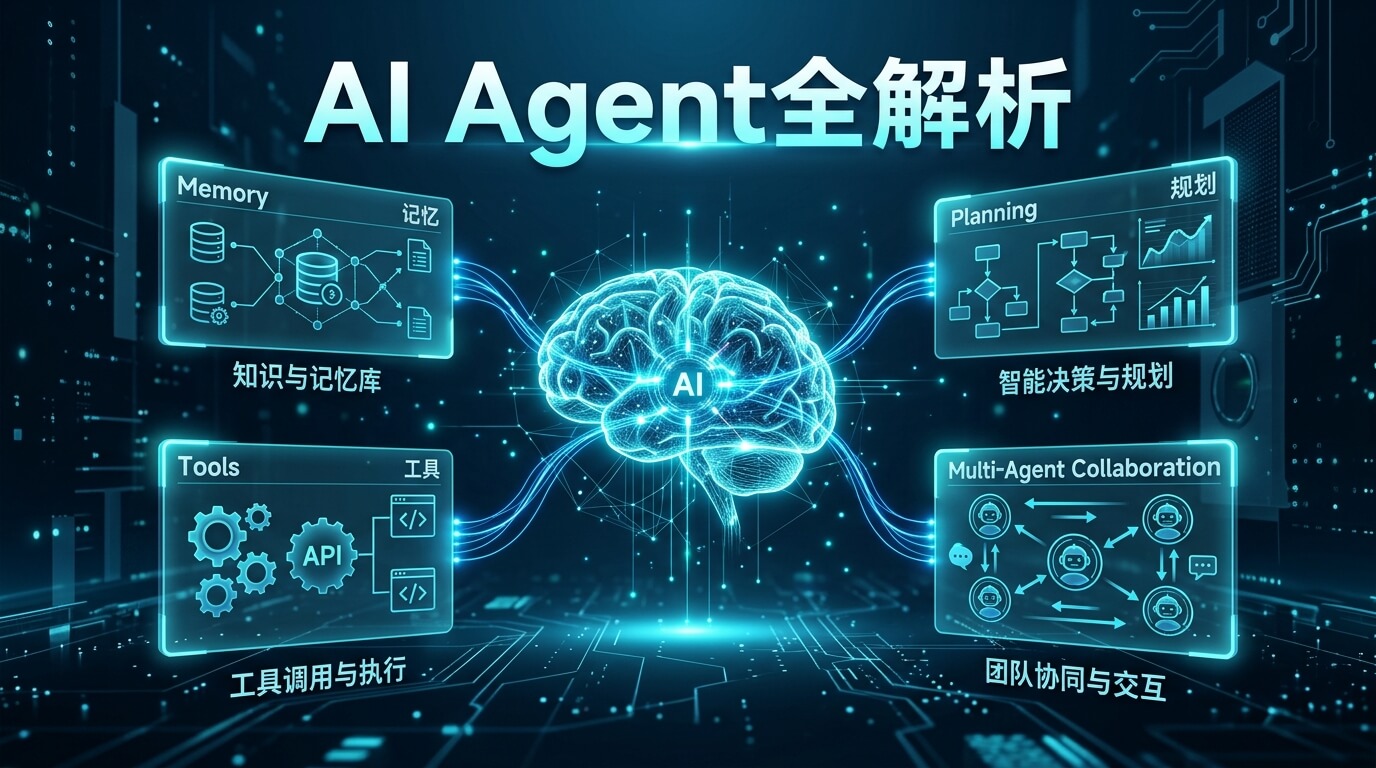
AI Agent = LLM(大脑) + 规划(Planning) + 工具(Tool) + 记忆(Memory),在一个循环(Loop)里自主完成任务。
拆开来看,它对应人的几项能力:
| 人的能力 | Agent 的对应部分 | 作用 |
|---|---|---|
| 大脑 | LLM | 理解目标、推理、做决策 |
| 思考怎么做 | Planning | 把大任务拆成小步骤 |
| 双手 | Tool 调用 | 查资料、写代码、调 API |
| 记忆 | Memory | 记住上下文和中间结果 |
| 节奏感 | Loop + 状态管理 | 一步步推进、知道做到哪了 |
举个例子。你丢给它一句:"帮我研究一下'低代码平台'这个赛道,写一份 500 字的行业简报。"
一个普通的 LLM 会直接凭空写一篇(还可能是编的)。而一个 Agent 会这样干:
- 先规划:拆成"搜索资料 → 阅读整理 → 提炼要点 → 写简报 → 自查"几步;
- 再动手:调用搜索工具查资料、调用阅读工具读网页;
- 边做边记:把查到的要点存进记忆;
- 循环推进:每完成一步,检查结果,决定下一步;
- 最终交付一份基于真实资料的简报。
看明白了吗?Agent 和 LLM 最大的区别,就在于多了一个"闭环"——它能自己规划、自己行动、自己检查、自己调整,直到把事情办成。
二、Agent 的基本架构:五个核心部件
无论哪个框架(LangChain、AutoGPT、自研),一个 Agent 的骨架基本一致:
             ┌────────────────────────────────┐
             │         用户目标 (Goal)          │
             └────────────────────────────────┘
                              ↓
        ┌─────────────────────────────────────────┐
        │               AI Agent                  │
        │                                          │
        │   ┌──────┐   ┌──────────┐   ┌────────┐  │
        │   │ LLM  │←→│ Planning │←→│ Memory │  │
        │   │(大脑) │   │ (规划)   │   │ (记忆) │  │
        │   └──────┘   └──────────┘   └────────┘  │
        │        ↕                ↕                │
        │   ┌──────────────────────────┐           │
        │   │        Tool 调用          │           │
        │   │  搜索/代码/API/数据库     │           │
        │   └──────────────────────────┘           │
        └─────────────────────────────────────────┘
                              ↓
执行结果 (Result)这五个部件各司其职:
- LLM(大脑):负责理解、推理、做决策,是 Agent 的核心;
- Planning(规划):把大目标拆解成可执行的子任务;
- Tool(工具):Agent 的"手脚",用来查资料、跑代码、调接口;
- Memory(记忆):存储上下文、中间结果和长期知识;
- Loop + State(循环与状态):把以上部件串成一个持续推进的流程。
后面几节,我们就沿着"这个骨架是怎么转起来的"这条线,一个个拆开讲。
三、Agent 的运行流程:一个永不停歇的 Loop
Agent 干活的核心,是一个循环(Agent Loop)。它大致长这样:
         ┌──────────────────────────────┐
         │                              │
         ↓                              │
   观察当前状态 (Observation)           │
         │                              │
         ↓                              │
   思考下一步该做什么 (Thought)          │
         │                              │
         ↓                              │
执行一个动作 (Action) ────────────────┘这个循环为什么如此重要?因为现实任务往往不是一步到位的。你没法一次就"订好机票"——你得先查航班、再比价、再下单、再确认,中间每一步的结果都会影响下一步。
所以 Agent 不是"一次输出答案",而是"反复地:看 → 想 → 做 → 再看",直到达成目标。这个循环,就是 Agent 的"心跳"。
一个关键点是:循环需要有退出条件。要么任务完成,要么达到最大步数,要么发现自己卡死了需要向用户求助——否则 Agent 会陷入无限循环。这就是为什么后面要专门讲"状态管理"。
四、ReAct:Agent 循环的经典范式
把上面的循环落地到代码层面,最经典、最常用的范式就是 ReAct(Reasoning + Acting,推理 + 行动)。
ReAct 把每一步循环拆成三个动作:
| 步骤 | 含义 | 例子 |
|---|---|---|
| Thought(思考) | 模型推理"现在该怎么办" | "用户想知道上海天气,我需要调用天气工具" |
| Action(行动) | 输出一个可执行的调用 | get_weather(city="上海") |
| Observation(观察) | 拿到工具返回的结果 | "上海,晴,25℃" |
然后基于 Observation,模型继续 Thought → Action → Observation……直到回答用户。
用代码视角看,ReAct 就是让 LLM 交替输出"思考"和"动作":
Thought: 用户想查上海天气,我需要调用天气工具。
Action: get_weather(city="上海")
Observation: 上海,晴,25℃

Thought: 拿到结果了,可以回答用户了。
Answer: 上海今天晴,气温 25℃。为什么 ReAct 这么重要?因为它把"推理"和"行动"绑在了一起:光思考不行动(纯 CoT)没法获取外部信息;光行动不思考(瞎调工具)会跑偏。ReAct 让两者交替进行,既聪明又能干。
五、Planning:Agent 如何拆解任务
循环决定了"怎么走",而 Planning(规划)决定了"先做什么、后做什么"。
面对一个复杂目标,Agent 不会(也不应该)上来就动手,而是先规划:
目标:写一份"低代码平台"行业简报
   │
   ├─ 1. 搜索"低代码平台 市场规模 2026"
   ├─ 2. 阅读并摘录 3-5 篇权威来源
   ├─ 3. 提炼核心观点
   ├─ 4. 生成 500 字简报
└─ 5. 自查:数据是否有来源、是否跑题规划能力主要靠两种手段:
- 任务分解(Task Decomposition):把大目标递归拆成小步骤。类似思维链(CoT),但更偏"行动",是"先计划再执行"。
- 反思与修正(Self-Reflection):执行过程中发现某一步错了(比如搜到的数据是旧的),就退回重做或调整计划。
一句话总结:Planning 让 Agent 从"想到哪做到哪",变成"先谋后动"。这正是 Agent 能处理复杂任务、而不是只能回答单个问题的关键。
六、Tool 调用:Agent 如何"动手"
规划再好,没有"手脚"也白搭。Tool 调用(工具调用)是 Agent 从"说"跨越到"做"的桥梁。
技术上,它依赖 Function Calling(函数调用)。核心机制是:模型不直接输出最终文字,而是输出一个结构化的调用指令,交给系统去执行:
{
  "tool": "get_weather",
  "args": { "city": "上海" }
}系统收到这个 JSON,就调用对应的 get_weather 函数,拿到结果后再交还给模型,让模型继续推理。
整个过程是一次"模型 ↔ 工具"的接力:
用户提问 → LLM 输出调用指令 → 系统执行工具 → 结果回传 → LLM 生成回答常见的工具包括:搜索引擎、代码解释器、数据库查询、各种外部 API(天气、地图、邮件)。而像 MCP 这样的协议,正是为了让模型能"即插即用"地接更多工具。
注意一个细节:工具的结果要回到模型手里,模型才能决定下一步。所以 Tool 调用天然和 Loop 绑定在一起——调完工具、拿到结果、继续循环。
七、Memory:Agent 如何"记住"
循环跑起来之后,马上会遇到一个现实问题:上下文会爆。
LLM 的上下文窗口是有限的,而 Agent 执行任务时会积累大量中间结果(搜索记录、工具输出、历史步骤)。如果全塞进上下文,很快就会超限、变慢、甚至丢失早期信息。
所以 Agent 需要 Memory(记忆),通常分三层:
| 记忆类型 | 存什么 | 放哪里 | 作用 |
|---|---|---|---|
| 短期记忆 | 当前对话/任务上下文 | 上下文窗口 | 维持连贯性 |
| 工作记忆 | 当前任务的中间结果、变量 | 状态对象(内存) | 跨步骤传递信息 |
| 长期记忆 | 历史经验、用户偏好、知识 | 向量库/数据库 | 跨会话复用 |
通俗地说:
- 短期记忆是"我现在正在想的事";
- 工作记忆是"我干活时写在便签上的笔记";
- 长期记忆是"我记在笔记本里、下次还能翻出来用的东西"。
长期记忆为什么用向量数据库?
这里"长期记忆"为什么专门放在向量库里,值得单独展开——它背后是 Agent 记忆最关键的底层设施。
长期记忆的核心难点在于:Agent 要"回忆起"和当前问题相关的内容,靠的不是一模一样的关键词,而是"意思相近"。
举个例子:用户先说过"我想去东京玩",过几天又问"上次说的日本行程定了吗?"——两句话措辞完全不同,Agent 却要能联想到"东京"和"日本行程"是同一件事。
这正是向量数据库擅长的事,思路分两步:
- 写入时:用 Embedding 模型把每段记忆变成一串数字(向量)。语义相近的文字,转成的向量在空间里也离得近;
- 读取时:把当前问题也转成向量,去数据库里找"距离最近"的那几条记忆,召回最相关的内容。
文字 → Embedding → 向量(一串数字) → 存入向量库
查询 → Embedding → 查询向量 → 相似度搜索 → 召回最相关的记忆那向量数据库里到底存的是什么?答案是:向量 + 它对应的原文(和可选元数据),两者一起存。
- 向量:一串数字,是 Embedding 算出来的"语义指纹",只负责算相似度;
- 原文:这段向量对应的原始文字,召回后真正要拿出来用的内容;
- 元数据:可选的附加信息(ID、用户、时间等),用于过滤和追溯。
一条记录大致长这样:
id: "mem-001"
vector: [0.02, -0.11, 0.87, ..., 0.45]      ← 用于相似度计算
text:   "用户喜欢去东京旅游,预算 8000 元"    ← 召回后真正使用的原文
meta: { user: "u_123", time: "2026-10-01" }关键就一句:向量是"找"用的钥匙,原文是"用"的内容。光存一堆数字没有意义,召回之后你得知道这段数字对应的是哪段文字。
和传统数据库对比一下就更清楚了:
| 传统数据库 | 向量数据库 |
|---|---|
精确匹配:WHERE 姓名 = '张三' | 语义匹配:找"意思最接近"的内容 |
| 存结构化数据(表、字段) | 存向量(一串数字) |
| 查"相等 / 范围" | 查"相似度" |
常见的向量数据库有 Pinecone、Milvus、Weaviate、Qdrant、Chroma,以及带 pgvector 扩展的 PostgreSQL。
一句话:向量数据库解决的是"语义记忆"的存取问题——它让 Agent 能"想起意思相近、而非字面相同的过去"。
Memory 的意义在于:让 Agent 不必把一切都记在脑子里(上下文),而是该存就存、该取就取,既节省上下文,又能跨步骤、跨会话保持连续性。
八、状态管理:把每一步"串"起来
前面讲了循环、规划、工具、记忆,它们之间靠什么协同?答案是 状态(State)。
可以把状态理解成 Agent 的"工作台面板"——它记录着:
- 当前做到哪一步了;
- 已经拿到了哪些中间结果;
- 下一步计划是什么;
- 目标有没有变化。
为什么状态管理如此关键?回到第三节那个循环:循环要能正确推进,靠的就是状态在每一步之间的传递和更新。
初始状态:目标=写简报,步骤=[],结果={}
   ↓ (执行第1步)
状态更新:步骤=[搜索],结果={关键词列表}
   ↓ (执行第2步)
状态更新:步骤=[搜索,阅读],结果={关键词列表, 摘要}
   ↓ ...
最终状态:步骤=[...全部完成],结果={简报草稿}状态管理带来三个实实在在的好处:
- 不失控:明确"下一步做什么",避免循环乱转;
- 可恢复:中途失败可以从上一个状态继续,而不是从头再来;
- 可观测:任何时候都能看清"做到哪了",方便调试和给用户解释。
可以说,状态是 Agent 的"主线",把循环、规划、工具、记忆串成了一个整体。理解了状态,才算真正理解了 Agent 的运行机制。
九、Multi-Agent:从"一个人"到"一个团队"
单 Agent 有天花板:一个模型既要规划、又要搜索、又要写代码、又要自查,角色太多就容易顾此失彼。
于是自然演进出了 Multi-Agent(多智能体):把任务分给多个各司其职的 Agent,让它们协作完成。
常见形态有两种:
- 编排者模式(Orchestrator):一个"主管 Agent"负责拆解任务、派活、汇总结果,下面一群"工人 Agent"各干各的。
            主管 Agent (编排者)
          /     |      \
         ↓      ↓       ↓
     研究员    写手    审校员
    (搜索资料) (写作)  (检查纠错)
         \      |      /
          ↓     ↓     ↓
汇总成最终成果- 对等协作模式(Peer-to-Peer):多个 Agent 平等对话、互相调用,像一场会议,你来我往地推进任务。
Multi-Agent 的价值很直观:
- 分工更专业:研究员专心搜索、写手专心写作、审校专心挑错,质量更高;
- 能力可扩展:需要新技能就加一个新 Agent,而不是把一个大模型越做越臃肿;
- 可相互校验:多个 Agent 可以交叉检查,减少幻觉。
当然,它也带来新的挑战——比如 Agent 之间怎么通信、怎么共享记忆、怎么避免"互相踢皮球"。这些本质上又回到了前文的主题:通信靠状态,共享靠记忆,协调靠一个更高层的 Loop。
所以 Multi-Agent 不是另起炉灶,而是把前面所有概念"放大成一个团队"来用。
总结:一张图看懂 AI Agent
回到最开始那句话:AI Agent 就是给 LLM 装上一套"能思考、能动手、能记忆、能规划、能循环推进"的框架。
把整条线索串起来:
  为什么需要 Agent?      LLM 只会说,不会做
           ↓
  Agent 是什么?           LLM + 规划 + 工具 + 记忆 + 循环
           ↓
  怎么运转?               Loop 循环:观察 → 思考 → 行动 → 再观察
           ↓
  循环的经典范式?         ReAct:Thought / Action / Observation
           ↓
  各部件怎么配合?         Planning 拆任务 → Tool 执行 → Memory 记结果
           ↓
  怎么不失控?             状态管理把每一步串起来
           ↓
怎么更强? Multi-Agent 多智能体协作理解了这条线,你就抓住了 AI Agent 的全部骨架。至于框架选型、工程细节,那都是在这套骨架上的具体实现——万变不离其宗。