什么是Embedding
更新: 10/13/2026字数: 0 字 时长: 0 分钟
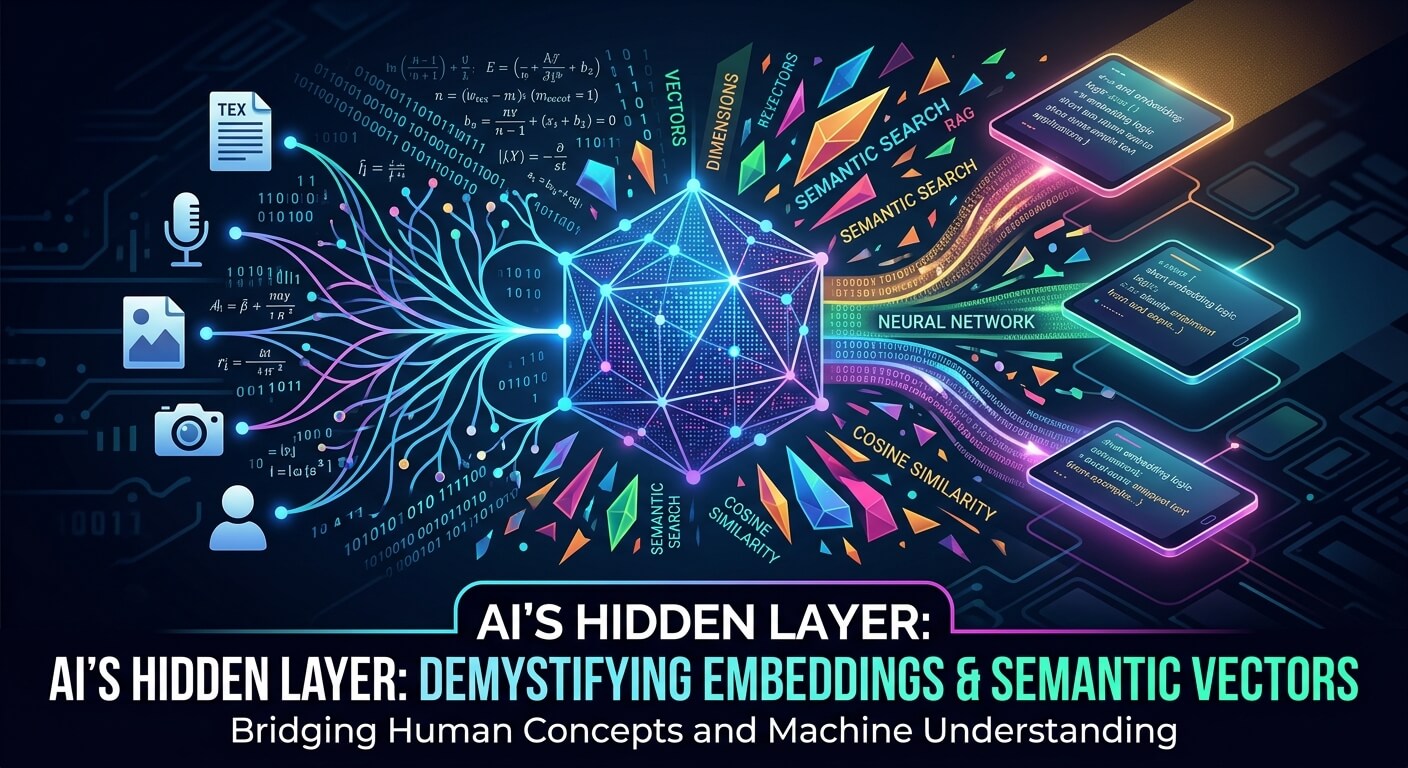
在人工智能和自然语言处理领域,Embedding(嵌入)是一个极其核心且基础的概念。简单来说,它是连接人类复杂语言与计算机数学世界之间的“桥梁”。本文将从定义、表现形式、计算过程到典型应用,系统梳理这一关键概念。
Embedding 中文近似读音:"伊姆-贝-丁"一、什么是 Embedding?
在计算机眼中,文字、图片、音频等人类直观感知的信息无法直接进行加减乘除运算。Embedding 的本质,就是将这些非结构化的数据转化为一串稠密的、连续的实数向量。
直观理解:想象一个巨大的多维空间(比如 1536 维),每一个维度代表某种抽象特征。经过训练的 Embedding 模型能够做到——语义相近的内容,在向量空间中的距离也靠得非常近。例如“国王”和“女王”的向量距离会很近,而“国王”和“冰箱”的向量距离会非常远。
为什么需要 Embedding?
在 Embedding 出现之前,计算机处理文本主要依赖 One-Hot Encoding(独热编码),但它存在明显缺陷:
- 维度灾难:词表越大,向量维度越高,且极度稀疏。
- 无法体现关联性:任意两个 One-Hot 向量正交,计算机无法看出“苹果”和“香蕉”都是水果。
而 Embedding 的优势在于:
- 低维稠密:用固定大小的低维稠密向量代替超高维稀疏向量。
- 捕捉语义:能够表达概念之间的隐式关系,经典例子如:Vector(国王) - Vector(男人) + Vector(女人) ≈ Vector(女王)。
二、Embedding 长什么样?
在计算机眼里,Embedding 没有任何神秘的文字或图像,它本质上就是一串固定长度的浮点数数组。
用 Python 调用模型将“人工智能”转成向量,返回结果通常如下:
[
  0.0234, -0.4125,  0.8912,  0.1023, -0.5674,
  0.3421,  0.1102, -0.0983,  0.6721, -0.2341,
  // ... 中间省略几百甚至上千个数字
  0.1423, -0.0124,  0.4512, -0.8912,  0.3341
]关键特征:
- 稠密且连续:每个数字都是浮点数,绝大多数位置不为 0。
- 维度固定:同一模型输出的向量维度完全固定。例如 OpenAI 的
text-embedding-3-small输出 1536 维,某些轻量开源模型可能是 384 维或 768 维。 - 无人类可读性:单独拿出一个数字,人类无法直接看出它代表什么。它是神经网络在海量数据中自主学习抽象出来的“隐特征”。
三、Embedding 是怎么计算出来的?
Embedding 并非凭空产生,而是通过经过海量数据训练好的神经网络模型计算出来的。以“我喜欢猫”为例,计算过程分为以下几步:
第 1 步:分词与词表映射
计算机不认识完整的汉字,首先需要把句子切成更小的单位(Token),每个 Token 在模型词表中对应一个初始的数字编号(ID)。
第 2 步:基础向量查表与位置编码
模型内部有一个巨大的权重矩阵,每个 Token ID 通过查表变成一个初始向量。同时,模型会将位置信息叠加到向量中,因为“我咬了狗”和“狗咬了我”字一样,意思完全不同。
第 3 步:深层神经网络处理
这是最核心的环节。带有初始向量的词语穿过模型的多层 Transformer 层:
- 自注意力机制:模型让每个词和句子中的其他词进行“对话”和计算权重。例如“苹果”在“苹果手机”上下文中会向“科技、电子产品”靠拢,在“苹果水果”上下文中则向“食物、农业”靠拢。
- 经过几十层的矩阵乘法、非线性变换后,每个词都吸收了丰富的上下文语义。
第 4 步:池化
如果我们要的是整句话的 Embedding,模型需要把一句话中所有词的向量“压缩”并合并成一个固定大小的向量。常用方法有 Mean Pooling(均值池化)或提取特殊的聚合标记(如 BERT 的 [CLS] 标记)。
第 5 步:归一化
最后通常会对向量进行归一化处理(让向量的模长为 1),方便后续用余弦相似度进行高效率计算。
四、Embedding 是如何被训练出来的?
模型在出厂前,是如何学会让“语义相近的词/句向量靠得很近”的呢?
- 自监督学习:让模型阅读互联网上的数十亿网页、书籍。
- 预测与对齐:比如玩“完形填空”游戏,或通过对比学习——强行让语义相似的句子在向量空间里靠拢,让无关的句子远离。
通过海量数据的训练后,模型内部的参数矩阵被不断修正,最终具备了神奇的“语义理解与几何映射”能力。
五、相关核心概念
围绕 Embedding,构建现代 AI 生态的几个关键概念包括:
① 向量空间
Embedding 所在的数学空间。每一个对象都是这个空间里的一个坐标点。维度的数量决定了空间的复杂度。
② 相似度计算
- 余弦相似度:计算两个向量夹角的余弦值,关注方向的一致性(最常用,取值范围 [-1, 1],值越大越相似)。
- 欧氏距离:计算向量空间中两点之间的直线距离。
- 内积:评估向量的大小与方向。
③ 向量数据库
当需要存储海量 Embedding 并进行毫秒级相似度搜索时,传统数据库无能为力,因此诞生了向量数据库(如 Milvus、Pinecone、Qdrant、Chroma 等),它们针对高维向量的近邻搜索进行了极致优化。
④ 维度降维与可视化
高维向量人类无法直观看到。科学家会使用降维算法(如 t-SNE 或 PCA)将高维向量压缩到 2D 或 3D 平面上,画成散点图,以便直观观察聚类效果和语义分布。
六、典型应用场景
RAG(检索增强生成)与大模型外挂知识库:将海量文档切段并转换为 Embedding 存入向量数据库。用户提问时,将问题转为 Embedding,在数据库中快速检索出最相关的文档,喂给大模型参考,从而减少幻觉并提供准确事实。
语义搜索:不再依赖关键词精确匹配。Embedding 搜索能理解“我想买一台智能手机”和“推荐一款苹果设备”之间的语义关联。
推荐系统:将用户行为和商品特征都映射到同一个向量空间,计算用户向量与商品向量的距离,实现精准推荐。
分类与聚类:将大批文本转为 Embedding 后直接聚类,自动把海量用户反馈按主题归类。
结语
Embedding 是 AI 理解世界的基础。它把人类的语言、图像、行为转化为计算机能够运算的向量,并通过向量空间中的距离来表达语义的相似性。理解了 Embedding 的表现形式和计算过程,就能彻底解开 AI 处理语言的“黑箱”面纱。无论是 RAG、语义搜索还是推荐系统,Embedding 都是背后不可或缺的核心技术。