什么是 AI 命中缓存?
更新: 10/13/2026字数: 0 字 时长: 0 分钟
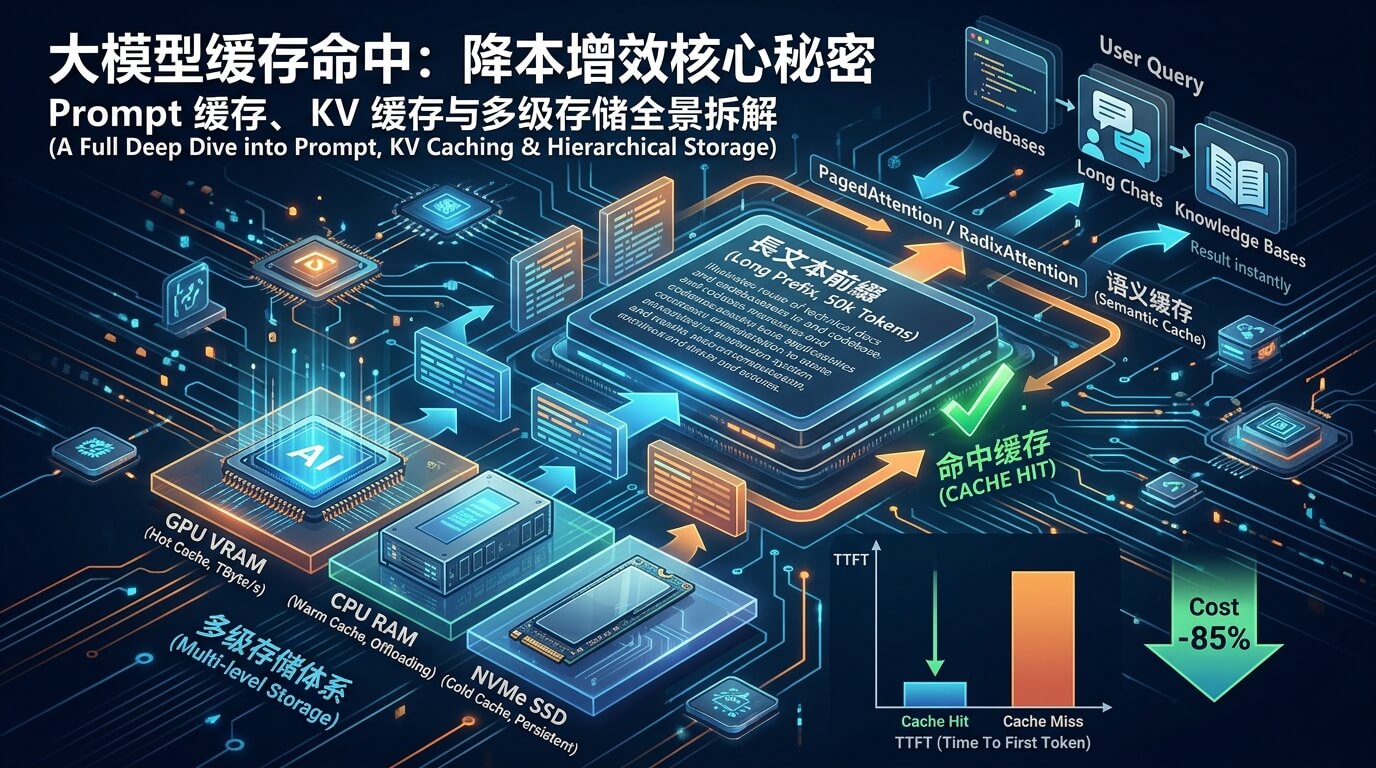
AI 命中缓存(通常在技术上被称为Prompt 缓存或KV 缓存命中)是大模型(LLM)领域中一项非常核心的降本增效技术。
简单来说,它的意思就是:AI 把你之前问过的内容、或者长篇大论的背景资料(比如整本书、长代码、系统提示词)存放在高速缓存里。当你下一次再问相似的问题、或者重复使用这些资料时,AI 不用像第一次那样从头到尾重新计算,而是直接“抄作业”,把之前存好的结果拿出来用。
下面从原理、好处、适用场景以及底层实现几个方面详细拆解。
一、 为什么 AI 需要缓存?(通俗原理)
大模型处理文本时,有一个特点:它是按顺序一个字一个字(Token)来理解和计算的。
- 第一次请求(未命中缓存 / Cache Miss): 如果你给 AI 发送了一篇 10,000 字的技术文档,并问它一个问题。AI 需要把这 10,000 个字完完整整地“读”一遍、计算一遍它们之间的关系。这个过程计算量极巨大,既花时间(延迟高),又耗费算力(成本高)。
- 第二次请求(命中缓存 / Cache Hit): 如果你紧接着又问了第二个问题,依然基于这篇 10,000 字的文档。因为系统开启了缓存,AI 发现:“这前 10,000 字的内容我刚才已经完全算过了,结果都存着呢!” 于是,它直接跳过了重新阅读这 10,000 字的痛苦过程,只去计算你最后那句新问题。
在技术底层,这主要通过复用大模型注意力机制中的 KV 缓存(键值对缓存) 来实现,能把长文本处理的计算复杂度大幅降低。
二、 命中缓存有什么好处?
对普通用户和开发者来说,“命中缓存”带来了三个极其直观的变化:
- 速度飞快(降低延迟): 未命中缓存时,处理超长 Prompt 可能需要等好几秒甚至十几秒;一旦命中缓存,响应速度通常能瞬间提升数倍,几乎是秒回。
- 省钱(降低 API 费用): 对于调用各大厂商大模型 API(如 OpenAI、Anthropic、通义千问等)的开发者来说,主流厂商对“命中缓存”的输入 Token 通常会有巨幅折扣(比如便宜 50% 到 90% 不等)。
- 减轻服务器压力: 服务器不需要重复进行高强度的矩阵运算,从而能支持更多人同时在线使用。
三、 在什么情况下容易“命中缓存”?
AI 缓存并不是对所有对话都有效,它通常在以下场景中“命中率”最高:
- 固定长上下文 / 知识库问答: 比如你做了一个智能客服,内置了 5 万字的公司规章制度作为背景(System Prompt)。所有用户来问问题时,这 5 万字的前置背景都是一样的,后续的问题只要连着这部分一起发,就很容易触发缓存。
- 多轮长对话: 在同一个对话框里,你和 AI 聊了很久。你发第 5 条消息时,前 4 条消息的内容如果被系统缓存了,AI 就能快速接着上下文回答。
- 代码库辅助编程: 每次把整个项目的代码框架传给 AI 让它帮你改错,如果代码没变,后续的提问就能直接命中代码缓存。
四、 缓存机制分哪几层?
大模型的缓存主要发生在 两个层面:推理层(模型推理基础设施)和 应用层(AI 应用与系统架构)。两者的缓存内容、存放位置、工作机制完全不同。
4.1 推理层:KV Cache 与 Prompt Caching
这是模型厂商(OpenAI、Anthropic、DeepSeek 等)和推理框架(vLLM、SGLang、TensorRT-LLM)最核心的缓存技术,针对的是模型计算过程中的中间结果。
原理: 大模型处理输入文本(Prompt)时,会把每个 Token 计算为注意力机制(Self-Attention)中的 Key(键) 和 Value(值) 向量。这些向量计算极耗算力,如果系统检测到当前请求与之前某个请求前缀完全一致(如固定系统提示词、长文档),就会直接复用已算好的 KV 向量,只计算新补充的内容——这就是常说的 KV Cache / 前缀缓存(Prefix Caching)。
KV 向量本身是数据结构,命中算法由推理框架在服务端实现:
- 分块哈希匹配(vLLM 的 Automatic Prefix Caching): 把长文本按固定大小(默认每 16 个 Token)切成“数据块”并计算哈希,下一次请求只要开头的块哈希对得上,就直接命中该段缓存。
- 前缀树匹配(SGLang 的 RadixAttention): 把所有处理过的对话前缀存成一棵“基数树”(Radix Tree),新请求沿树匹配分支,即可定位并复用对应的 KV 缓存。
而在 API 平台层(OpenAI、Anthropic、智谱、通义千问等厂商),入口网关会先检查请求前缀(系统提示词、长文档等)是否和几分钟前处理过的某段请求完全一致;若一致,就把请求路由到“已经持有该缓存”的 GPU 服务器上,并按折扣价计费。
命中缓存的规则只有一条:必须从 prompt 最开头开始完全一致。改一个标点、换一行顺序,都可能导致缓存失效。
4.2 应用层:精确匹配缓存与语义缓存
这一层由 AI 应用开发者(LangChain、Dify 或自研系统)掌控,目的是在请求还没发给大模型之前就把它拦截下来。
- 精确匹配缓存(Exact Match Cache): 检查用户输入是否和历史上某个问题一模一样(如“公司的上班时间是几点?”),一致就直接返回上次的回答,完全不调用大模型。
- 语义缓存(Semantic Cache): 先用轻量级 Embedding 模型把问题转成向量,再到向量数据库里比对。若新问题与历史问题语义足够接近(相似度高于阈值),就直接复用历史回答。这样“今天的天气”和“今天天气怎么样”也能命中同一份缓存。
五、 内容被缓存到哪里了?
以大模型最核心的 KV 向量 为例,它的体积非常庞大(通常几百 MB 到数十 GB),因此现代大模型系统采用 分级存储架构(Hierarchical Storage):
| 存储介质 | 存储位置 | 特点与角色 |
|---|---|---|
| GPU 显存 (HBM) | GPU 显卡内部(如 H100/A100 显存) | 热缓存(Hot Cache):读取速度极快(TB/s 级别),但容量小且极其昂贵。正在进行的多轮对话等高频上下文直接放在这里,保证秒级响应。 |
| 主机内存 (CPU RAM) | 显卡所在服务器的内存 | 温缓存(Warm Cache):容量大、相对便宜,通过 PCIe 通道与 GPU 通信。当 GPU 显存不够用时,暂时不用的 KV 缓存会被卸载(Offload)到这里。 |
| 本地高速 SSD / NVMe | 服务器硬盘 | 冷缓存(Cold Cache):容量大、成本低,但延迟更高,适合长期存放不常用、偶尔才会调用的长文本缓存(如历史上传的几万字 PDF)。 |
小结: 推理层的 KV / Prompt 缓存,缓存的是输入文字被模型“读懂”后的中间数学向量,存放在 GPU 显存 + 服务器内存 + 本地 NVMe 硬盘 构成的多级存储体系中,而不是最终回答文本。
应用层的两类缓存落点更简单:精确匹配缓存放 Redis / Memcached,语义缓存放向量数据库(Milvus、Qdrant、Pinecone、Chroma 或带 pgvector 的 PostgreSQL)。
5.1 一眼看全:三类缓存对比
| 缓存类型 | 缓存的内容是什么? | 缓存在哪里? | 主要解决什么问题? |
|---|---|---|---|
| Prompt / KV 缓存 (推理层) | 模型计算出的中间数学向量 (KV Tensor) | GPU 显存 + 服务器内存(RAM) + 高速 SSD | 降低长文本 / 多轮对话的计算延迟和 API 成本 |
| 精确匹配缓存 (应用层) | 原始文本键值对(问题 → 回答) | Redis / Memcached | 秒级响应完全相同的重复提问 |
| 语义缓存 (应用层) | 问题的语义向量 + 对应的历史回答 | 向量数据库(Milvus / Pinecone 等) | 秒级响应意思相近的相似提问 |
六、 缓存什么时候被清除?
“命中缓存”并不是永久有效的。缓存会因为两类原因消失:被动过期/淘汰 和 主动失效。
6.1 推理层:容量淘汰 + 服务重启
- 容量淘汰(LRU): KV 缓存占用显存/内存,空间有限。当不够用时,推理框架(如 vLLM)会按 LRU(最近最少使用) 把最久没用过的缓存块挤出去——不是“到点删除”,而是“没地方放就淘汰旧的”。
- 分级存储越往下越易失: 被卸载(Offload)到内存或 SSD 的缓存,本身就是“暂时不用”的,优先级更低。
- 服务重启 / 节点切换: 实例重启、扩缩容、请求被路由到另一台 GPU 机器,原缓存都无法复用——这也是企业级场景下命中率不稳定的常见原因。
6.2 API 平台层:TTL 到期 + 前缀变化
- TTL 到期: 各家厂商为缓存设置了有效期,通常在 5 分钟到 1 小时之间,且每次命中一般会“续期”重新计时。具体时长与计费以官方文档为准。
- 前缀变化立即失效: 只要系统提示词、工具定义、文档开头改了任何一个字符,前缀就不再一致,旧缓存立刻作废。
6.3 应用层:需要自己管过期
- Redis / Memcached: 通过
TTL(EXPIRE)到期自动删除,或按maxmemory+ 淘汰策略(如 LRU)挤掉旧数据,也可手动删除。 - 语义缓存: 除了 TTL,还要在知识更新、答案过期时主动失效,否则会持续返回过时回答。
一句话总结:被动清(TTL 到期 / 容量淘汰) 与 主动失效(前缀改变 / 版本更新 / 手动删除),是缓存消失的两条路径。
各厂商缓存有效期与计费的详细对比,见 模型上下文与命中缓存。
总结
“AI 命中缓存”就像是 AI 拥有了“短期记忆的外挂”。它不用每次都把看过的厚厚资料从头到尾读一遍,而是把之前做过的笔记直接拿来用,从而实现了又快又省钱的效果。