为什么 AI 编辑器动不动爆内存,CPU 却在打瞌睡?
更新: 10/13/2026字数: 0 字 时长: 0 分钟
不知道你有没有注意到这样一个“怪现象”:
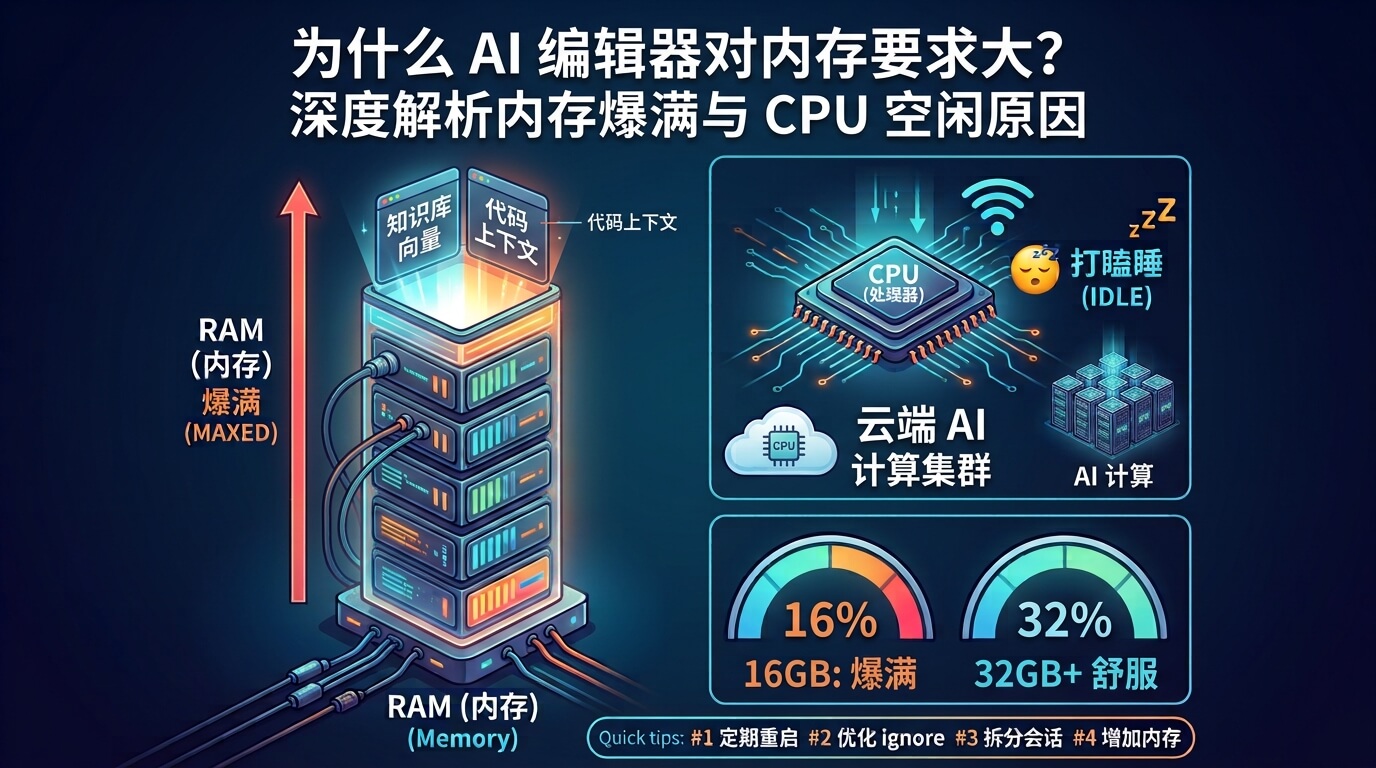
当你打开 Cursor、CodeBuddy,或者开启 ChatGPT 桌面版、Claude Code、Copilot 进行辅助编程时,任务管理器里的内存(RAM)使用率一路飙升,甚至直接爆满,导致电脑卡顿甚至假死。然而转头一看 CPU 使用率,却只有可怜的 5%~20%,仿佛在打瞌睡。
按常理,AI 这么高级的技术,难道不应该极其消耗 CPU/GPU 的算力吗?为什么现在的 AI 编辑器表现得像个“内存吞噬兽”,却对 CPU 无动于衷?
本文将为你深度拆解 AI 编辑器背后的资源消耗模型,带你搞懂为什么 在 AI 编程时代,32GB 内存正在成为新的开发门槛。
一、传统 IDE vs AI 编辑器:资源消耗模型的本质变革
要搞懂这个问题,首先得明白传统编辑器与 AI 编辑器在工作流程上的本质区别。
1. 传统 IDE 的工作流(轻量、按需)
传统 IDE(如 VS Code、Sublime Text)的工作方式非常简单:
它主要消耗:当前打开的文件缓存、AST 语法树、少量插件和语言服务(LSP)。通常只需要 几百 MB 到 2GB 内存即可流畅运行。
2. AI 编辑器的工作流(全量、驻留)
而现代 AI 编辑器(如 Cursor / CodeBuddy)在背后做的事情要复杂得多:
现在的 AI 编辑器,本质上是一个 “IDE + 搜索引擎 + 向量数据库 + 智能 Agent 运行环境” 的结合体。为了实现“懂你的代码库”,它必须将大量数据实时驻留在内存中。
二、四大“内存杀手”:究竟是谁吃光了你的 RAM?
杀手 1:代码库索引与向量数据库(最大的内存占用源)
当你在 Cursor 或 CodeBuddy 中打开一个中大型项目时,AI 并非只读取你当前正在编辑的那一页代码,它需要理解整个项目的结构、类继承关系和 API 调用。
它会在后台进行以下处理:
代码文件 ──> AST 语法树 ──> 分块 (Chunking) ──> Embedding 向量 ──> 本地索引/向量库在一个拥有 10,000 个源文件的项目中,数据的膨胀是非常惊人的:
| 数据类型 | 实际体积/内存占用 |
|---|---|
| 源代码文件 | ~ 500 MB |
| 搜索与 AST 索引 | ~ 2 GB |
| Embedding 向量数据 | ~ 5 GB |
| 模型补全与运行缓存 | ~ 2 GB |
| 占用总计 | 约 9.5 GB+ |
光是为项目建立“感知”并保存在内存中,就已经把 16GB 内存吃掉了大半。
杀手 2:滚雪球般的对话上下文(Context Window)
你在使用 AI 编辑器时,上下文并非只有“你输入的一句话”。为了给云端模型提供精准的背景,编辑器会在内存中持续维护一个巨大的上下文包:
内存中的上下文 = 当前打开的文件 + 关联代码块 + 历史修改记录 + 终端错误日志 + 多轮 AI 对话历史 + Code Diff
随着对话推进,上下文 Token 数会迅速飙升:
- 第 1 轮对话:
- 第 10 轮对话:
- 第 30 轮长会话:
为了做到“毫秒级响应”和“即时回显”,这些海量的上下文状态都会被实时保存在内存中。
杀手 3:Electron 架构带来的天然多进程开销
大部分 AI 编辑器(如 Cursor、CodeBuddy)都是基于 Electron 框架开发的。
Electron 本质上是把一个 Chromium 浏览器内核 + Node.js 运行时 打包进了软件。在一个 AI 编辑器中,通常会同时跑着多个独立进程:
- 主窗口进程(UI 渲染)
- VS Code 核心服务
- AI Agent 运行环境
- 本地 Embedding / 索引服务
- 各种语言服务器(LSP)与插件进程
光是把软件跑起来,什么都不干,多个进程叠加就已经轻松吃掉 3GB ~ 5GB 的内存。
三、为什么 CPU 反而极其空闲?
明白了大模型的工作原理,就很容易理解为什么 CPU 使用率往往只有 5%~20% 了。
因为:计算的主战场变了。
【你的电脑 (客户端)】                     【云端服务器 (算力中心)】
┌────────────────────────┐                ┌────────────────────────┐
│  • 界面渲染            │   网络 HTTP/   │  • 数以亿计的矩阵乘法  │
│  • 文件管理 & 索引     │ ─────────────> │  • LLM 大模型推理      │
│  • 内存上下文维护      │ <───────────── │  • GPU / TPU 集群计算  │
└────────────────────────┘ SSE / WS 流 └────────────────────────┘- 以前(本地计算):你在 Photoshop 里跑滤镜或编译 C++ 代码,所有指令都在你本地 CPU/GPU 上硬算,CPU 瞬间拉满。
- 现在(云端端侧分离):真正的 AI 大模型推理(如 GPT-4o、Claude 3.5 Sonnet)发生在云端拥有成千上万张 H100/A100 的 GPU 集群上。你的电脑只是个 “高级客户端”,CPU 只需要做简单的网络收发、界面渲染和文本拼接,自然非常空闲。
四、为什么内存爆满后,电脑会“瞬间假死”?
很多开发者会问:“既然 CPU 很空闲,为什么我的鼠标和界面还会卡顿呢?”
答案是:触碰了虚拟内存(Swap/Pagefile)的性能断层。
当你的物理内存(RAM)被 AI 编辑器撑爆后,操作系统为了不崩溃,会将一部分暂时不用的内存数据强行写入硬盘(SSD/HDD)作为“虚拟内存”:
我们来看看不同介质之间的读写速度差距:
| 存储介质 | 读写带宽 (速度) | 相对性能 |
|---|---|---|
| DDR5 内存 | ~ 50 GB/s - 80 GB/s | ⚡ 极快 |
| PCIe 4.0 NVMe SSD | ~ 5 GB/s - 7 GB/s | 🐢 慢 10 倍 |
| 机械硬盘 (HDD) | ~ 100 MB/s - 200 MB/s | 🐌 慢 500 倍 |
一旦进入“磁盘交换”状态,哪怕 CPU 使用率只有 1%,系统也必须花几秒甚至几十秒等待硬盘的数据搬运。这就直接表现为鼠标卡顿、输入法延迟、浏览器冻结和 IDE 无响应。
五、AI 开发时代,开发者该如何配置内存?
随着 AI 工具全面嵌入工作流,传统的硬件选购逻辑发生了巨大改变。
1. 不同内存配置的真实体验评估
- ❌ 8GB 内存(基本不可用): 操作系统占用 3GB + 浏览器 2GB + AI 编辑器 4GB = 瞬间爆满。极其卡顿。
- ⚠️ 16GB 内存(勉强可用 / 入门): 适合写小型 Python 脚本或前端单页应用。如果项目规模稍大或开启多个长会话,容易频繁掉帧。
- 🟢 32GB 内存(当前的“黄金甜点位”): AI 时代的标准开发配置。可以同时顺畅运行 Cursor/CodeBuddy + 浏览器数十个标签页 + Docker 容器 + 本地数据库。
- 🚀 64GB 及以上(大型项目与本地模型首选): 适合大型微服务架构、需要同时开启多个 AI 编辑器窗口,或者需要在本地部署 Ollama / Llama 3 (Quantized) 等本地大模型的重度开发者。
硬件升级优先级建议: 内存 (RAM)
固态硬盘 (SSD) CPU 独显 (GPU)
六、5 个有效降低 AI 编辑器内存占用的技巧
如果暂时无法升级硬件,可以通过以下习惯来优化内存使用:
- 精准配置
.cursorignore或.gitignore: 务必阻止 AI 索引扫描node_modules、dist、build、logs、.git等无关大文件夹。 - 切忌“单会话聊到底”: 不要在一个 Chat 窗口里连续对话数小时。建议按照功能模块拆分会话(例如:登录模块一个 Chat,订单重构一个 Chat),功能完成后及时开启 New Chat。
- 定期重启 AI 编辑器: Electron 架构的应用普遍存在一定程度的缓存释放不彻底问题,工作半天重启一次 IDE 能释放数 GB 内存。
- 控制同时打开的项目窗口: 每一个 AI 编辑器窗口都是一个独立的 Electron 进程和索引服务,尽量避免同时开启 3 个以上的大型项目。
- 及时清理无用插件: 禁用不常用的语言服务(LSP)和三方插件,减少内存常驻服务。
总结
一句话概括 AI 编辑器的硬件逻辑:
AI 编辑器之所以极其吃内存,是因为它正在把你的整个项目代码库,实时构建并维护为一个可搜索、可理解、可推理的“本地知识库”;而 CPU 极其空闲,是因为真正耗费算力的大模型推理全都发生在云端 GPU 集中集群上。
在未来的 AI 编程工具链中,IDE 将越来越像一个 “浏览器 + 本地向量库 + 智能 Agent 客户端” 的组合。32GB 内存,正在悄然成为 AI 时代开发者的硬件新起点。